Lecteur fourni par Orange Mastermedia. Le lancer lui transmet des données de navigation.
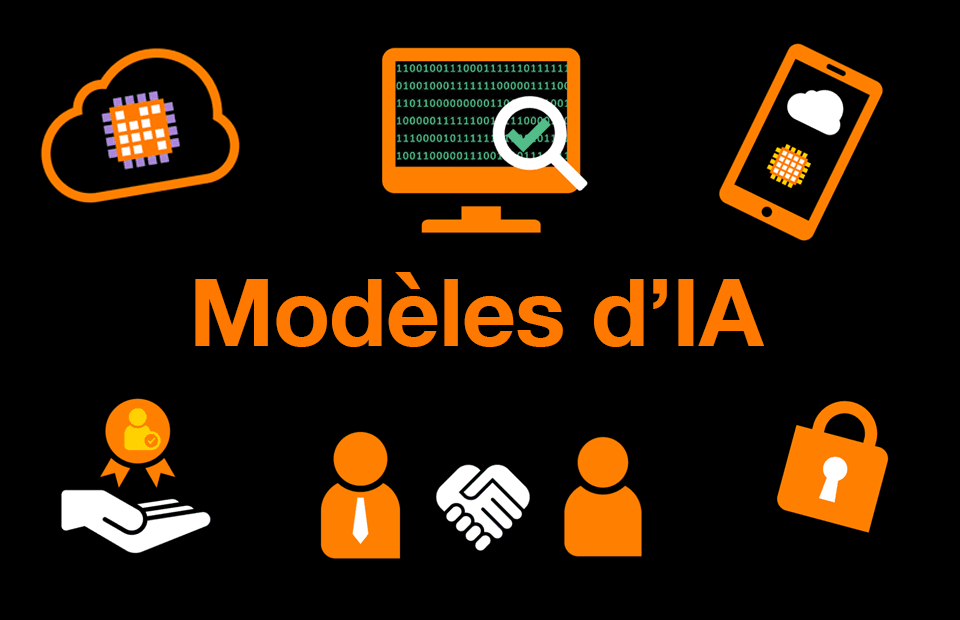
Il existe trois catégories principales de modèles d’intelligence artificielle : les modèles dits « open weight », les modèles « open source » et les modèles « fermés ». Il convient d’en préciser les caractéristiques fondamentales.
Le modèle « open weight » se définit comme un modèle téléchargeable et exécutable sur une infrastructure personnelle ou cloud, sans que l’accès à ses mécanismes de conception ne soit divulgué. Cette catégorie inclut, par exemple, les modèles Llama, Qwen ou certaines versions de Mistral.
La coexistence de ces trois paradigmes répond à des besoins distincts pour les utilisateurs et les fournisseurs.
Les modèles « open source », quant à eux, offrent un niveau de divulgation supérieur. Non seulement ils sont téléchargeables, mais ils fournissent également un accès intégral à leurs composantes, permettant ainsi leur analyse, leur compréhension et leur ré-entraînement. Cet accès couvre l’ensemble des données d’apprentissage ainsi que les spécifications techniques détaillées. On peut citer, à titre d’illustration, les modèles BLOOM ou, plus récemment, OLMo.
À l’opposé, les modèles « fermés » ne sont pas téléchargeables. Leur utilisation est restreinte à des services en ligne dédiés. Les modèles GPT-4, GPT-5 ou Gemini en sont des exemples typiques. Leur architecture interne et leur processus de développement demeurent opaques. Ces systèmes intègrent fréquemment des couches supplémentaires visant à renforcer leur robustesse et leur fonctionnalité, telles que des filtres de sécurité ou des modules d’accès à l’internet.
La coexistence de ces trois paradigmes répond à des besoins distincts pour les utilisateurs et les fournisseurs.
Quel contrôle pour les utilisateurs ?
Du point de vue de l’utilisateur, la question centrale est celle du contrôle. Certains privilégient l’exploitation autonome des modèles au sein d’infrastructures sécurisées, tandis que d’autres requièrent la possibilité de les personnaliser ou de les modifier.
Pour les fournisseurs, les modèles fermés et open weight permettent de préserver la propriété intellectuelle et le savoir-faire technique. Les modèles fermés offrent en outre un contrôle accru sur les conditions d’utilisation, notamment via le filtrage des requêtes. La stratégie open weight, favorise l’adoption large et le développement d’un écosystème économique autour du modèle.
Enfin, les modèles open source répondent à un enjeu de transparence et de confiance. Bien que leurs performances puissent être comparativement limitées, ils constituent des ressources essentielles pour la recherche académique, la régulation et toute organisation devant expliquer les mécanismes sous-jacents au fonctionnement d’un modèle.
Chaque typologie possède sa légitimité et son utilité spécifique. Aucune ne surpasse les autres de manière absolue : le choix doit procéder d’une analyse rigoureuse des besoins, complétée par un examen attentif des licences et conditions d’utilisation établies par les fournisseurs.